martes, 7 de febrero de 2012

Unidad # 2 Estructura y propiedades del material genético

SEP                      SNEST                      DGEST

INSTITUTO TECNOLÓGICO DE CIUDAD ALTAMIRANO

Unidad # 2
Estructura y propiedades del material genético
Que Presenta:
Rubén Santibáñez Alejandrez
09930057
Carrera:
Lic. En Biología

Ciudad Altamirano, Gro. México.  A 07 Febrero del 2012


Introducción
En este curso de biología celular se estudiará y se describirá con detalle las estructuras físicas y químicas de los ácidos nucleicos. A través de consultas y revisiones bibliográficas actuales para poder reafirmar y enriquecer los conocimientos básicos  de los ácidos nucleicos. La estructura química de los acidos nucleicos esta formada por un nucleótido idéntico entre si, excepto cuando cada nucleótido presenta una base nitrogenada diferente.

Los nucleótidos para el ADN están formados  por un grupo fosfato, una ribosa ósea una azúcar de 5 carbonos (desoxirribosa)  y una base   nitrogenada que puede ser; (A, G, C y T). 
 
Los nucleótidos para el ARN son los siguientes;  grupo fosfato, una ribosa ósea una azúcar de 5 carbonos (ribosa) y una base   nitrogenada que puede ser; (A, G, C y U).  

Para la diferenciación y reconocimiento de los ácidos nucleicos se estudiará a detalle  las estructuras físicas de los mismos. En la estructura física del  ácido desoxirribonucleico, Watson y Crick en 1953 diseñaron una estructura de doble hélice, siendo cada hélice una ristra larga de nucleótidos unidos por enlaces fosfodiester, manteniendo unidas las dos hélices por puentes de hidrogeno.  En cuanto a las propiedades físicas  del ácido  ribonucleico, el esta constituido por una sola cadena de nucleótidos, no es una hélice doble sino una hélice sencilla.


Objetivos del curso
1._ Reafirmar y enriquecer el conocimiento de los ácidos nucleicos a nivel químico para su manipulación.

2._ Observar y describir con detalle la estructura de las moléculas que participan en la transferencia de información.

viernes, 3 de febrero de 2012

1.3 Perspectivas futuras de la Biología Molecular.

Después de que los científicos lograron identificar el ADN como la molécula que contiene la mayoría, si no toda, de la información genética de una célula.  El campo de la geneática molecular avanzo rápidamente a finales de la década de los años 50 y principios de los años 60 proporcionado nuevos conceptos a una velocidad que solo puede compararse con la del desarrollo de al mecánica cuántica de los años 20.
                  
Las aplicaciones de la biología molecular y campo de estudio:


La medicina forense utiliza técnicas desarrolladas en el curso de la investigación sobre el ADN para identificar delincuentes. Las muestras de ADN tomadas de semen, piel o sangre en el escenario del crimen se comparan con el ADN del sospechoso; el resultado es una prueba que puede utilizarse ante los tribunales.


 La agricultura y la ganadería se valen ahora de técnicas de manipulación de ADN conocidas como ingeniería genética y biotecnología. Las estirpes de plantas cultivadas a las que se han transferido genes pueden rendir cosechas mayores o ser más resistentes a los insectos. También los animales se han sometido a intervenciones de este tipo para obtener razas con mayor producción de leche o de carne o razas de cerdo más ricas en carne y con menos grasa.


El estudio del ADN también ayuda a los taxónomos a establecer las relaciones evolutivas entre animales, plantas y otras formas de vida, ya que las especies más cercanas filogenéticamente presentan moléculas de ADN más semejantes entre sí que cuando se comparan con especies más distantes evolutivamente. Por ejemplo, los buitres americanos están más emparentados con las cigüeñas que con los buitres europeos, asiáticos o africanos, a pesar de que morfológicamente y etológicamente son más similares a estos últimos.


1.2 LA BIOLOGÍA MOLECULAR EN MÉXICO.

La biología molecular nace, asimismo, de la bioquímica. La bioquímica en sí, se gestó dentro del pensamiento cuantitativo, particularmente con la visión de que la vida se podía explicar a través de una serie de reacciones químicas, catalizadas por enzimas. Así se construyeron los grandes esquemas de las vías metabólicas que incluyen, entre otros muchos, el ciclo de Krebs, el ciclo de la urea, la cadena respiratoria, la biosíntesis de ácidos grasos, de las hormonas, y de las vitaminas y la fotosíntesis.   Como en todo el mundo, la biología molecular en México nació de la bioquímica. Hasta principios de la década de 1970.


Fortaleza.
Debilidad.
En 1970´s nace el instituto de investigaciones médicas. (IIBM).
México se encuentra muy por debajo de la media en cuanto a la elaboración de artículos científicos.
En 1976  es creado el  Centro de Investigación y Estudios Avanzados (CINVESTAV) del IPN. Haciendo estudios sofisticados sobre la regulación genética del fago lamda.
El (CONACyT) es la única fuente principal de recursos financieros para la investigación.
La UNAM creó, en el mes de abril de 1980 en la ciudad de Cuernavaca Morelos, el Centro de Investigación sobre Fijación de Nitrógeno (CIFN). Fue así como  (CIFN)  consolido trabajos sobre bacterias fijadoras de Nitrógeno.
Las inconsistencias en el programa de repartición de científicos Mexicanos que se encuentran en el extranjero
En abril de 1982, se creó en la ciudad de México el Centro de Investigación sobre Ingeniería Genética y Biotecnología (CIIGB).
La permanente ausencia de una política de apoyo.

1.1.4._ modelo del Operón

Se define como una unidad genética funcional formada por un grupo o complejo de genes capaces de ejercer una regulación de su propia expresión por medio de los sustratos con los que interaccionan las proteínas codificadas por sus genes.
Este complejo está formado por genes estructurales que codifican para la síntesis de proteínas (generalmente enzimas), que participan en vías metabólicas cuya expresión generalmente está regulada por otros 3 factores.


Factor promotor: zona que controla el inicio de la transcripción del operón, ya que la ARN Polimerasa tiene afinidad por ella. Realmente, como un gen es cada unidad de transcripción independiente, y puesto que el operón tiene un único promotor que controla toda su expresión, no hay elementos para decir que se trate de "varios genes" de expresión coordinada; más correcto sería decir que el operón es un único gen que codifica un ARNm policistrónico (es decir, con muchos codones de inicio y paro, con lo que a la hora de traducirse dará lugar a varias proteínas independientes). Sin embargo, es común referirse a los "genes" del operón para hacer referencia a las regiones que, una vez transcritas, codificarán proteínas independientes.
Operador: zona de control que permite la activación/desactivación del promotor a modo de "interruptor génico" por medio de su interacción con un compuesto inductor. Esto lo logra porque tiene secuencias reconocibles por proteínas reguladoras. Tras su unión, por plegamientos tridimensionales interacciona con la zona del promotor, donde las proteínas reguladoras que se han unido contactan con la ARN Polimerasa, aumentando o disminuyendo su afinidad por el promotor, y con ello dando lugar a la expresión/represión del resto de los genes estructurales.
Gen regulador: alguno de los genes del operón pueden codificar factores de transcripción que se unan al promotor, regulando así la propia expresión del operón. A toda regulación de la expresión realizada desde dentro del gen u operón se le llama "regulación en cis", pero puede haber también genes muy alejados del operón que codifiquen factores de transcripción para uno o varios otros genes u operones, y en este caso se hablaría de "regulación en trans".

1.1.3 El descubrimiento del código genético.

El código genético es un conjunto de normas por las que la información codificada en el material genético se traduce en proteínas en las células vivas. El código define la relación entre secuencias de tres nucleótidos, llamadas codones, y aminoácidos. Un codón se corresponde con un aminoácido específico. La secuencia del material genético se compone de cuatro bases nitrogenadas distintas, que tienen una función equivalente a letras en el código genético: adenina (A), timina (T), guanina (G) y citosina (C) en el ADN y adenina (A), uracilo (U), guanina (G) y citosina (C) en el ARN.

Debido a esto, el número de codones posibles es 64, de los cuales 61 codifican aminoácidos (siendo además uno de ellos el codón de inicio, AUG) y los tres restantes son sitios de parada (UAA, UAG, UGA). La secuencia de codones determina la secuencia aminoacídica de una proteína en concreto, que tendrá una estructura y una función específicas. Los codones constan de tres nucleótidos fue demostrado por primera vez en el experimento de Crick, Brenner y colaboradores. Marshall Nirenberg y Heinrich J. Matthaei en 1961 en los Institutos Nacionales de Salud descubrieron la primera correspondencia codón-aminoácido. Empleando un sistema libre de células, tradujeron una secuencia ARN de poli-uracilo (UUU...) y descubrieron que el Polipéptido que habían sintetizado sólo contenía fenilalanina.


Universalidad del código genético
El código genético es compartido por todos los organismos conocidos, incluyendo virus y organelos, aunque pueden aparecer pequeñas diferencias. Así, por ejemplo, el codón UUU codifica el aminoácido fenilalanina tanto en bacterias, como en arqueas y en eucariontes. Este hecho indica que el código genético ha tenido un origen único en todos los seres vivos conocidos.

miércoles, 1 de febrero de 2012

1.1.2 El descubrimiento de la estructura del ADN.

Los primeros que tuvieron éxito en descubrir la estructura fueron Watson y Crick en 1953- tuvieron en cuenta dos tipos de pistas. En primer lugar, Rosalind Franklin y Maurice Wilkins, habían acumulado muchos datos de difracción de rayos X sobre la estructura de DNA. El segundo tipo de datos procedía del trabajo de años antes de Edwin Chargaff. Estudio DNA de diferentes organismos, Chargaff estableció ciertas reglas empíricas sobre las cantidades de cada componente del DNA.

Rosalyn Franklin  observó  que el DNA tenía un espaciado regular de 0,34 nm. Éste y otros indicios indicaban que debe tener algún tipo de estructura en hélice que se repite periódicamente, los datos sugerían que el DNA era largo y fino y que consta de dos partes separadas que corre una al lado de la otra a lo largo de la molécula, también demostraba que la molécula era helicoidal.


Las reglas de Chargaff;
1._ la cantidad total de nucleótidos pirimidinicos (T + C) es siempre igual a al cantidad total de nucleótidos púricos (A + G).

2._  la cantidad de T es siempre igual a la de A y la cantidad de C es siempre igual a la de G. pero A + T no necesariamente es igual a C+G


Watson y Crick  en construyeron un modelo que cumpliera todas las investigaciones que sobre el DNA se habían realizado hasta la fecha y propusieron, además, cómo tenía que conservarse y transmitirse la información de esta molécula. También introdujeron que esta molécula se podía mutagenizar espontáneamente mediante la tautomería.


Desde el punto de vista químico, el ADN es un polímero de nucleótidos, es decir, un polinucleótido. Un polímero es un compuesto formado por muchas unidades simples conectadas entre sí, como si fuera un largo tren formado por vagones. En el ADN, cada vagón es un nucleótido, y cada nucleótido, a su vez, está formado por un azúcar (la desoxirribosa), una base nitrogenada (que puede ser adenina → A, timina → T, citosina → C o guanina → G) y un grupo fosfato que actúa como enganche de cada vagón con el siguiente.

1.1_ El desarrollo de la biología molecular.

William Astbury  en 1945 acuño el término de biología celular, refiriéndose  al estudio de la estructura química y física de las macromoléculas biológicas. Cuyo objetivo fundamental es la comprensión de todos aquellos procesos celulares, que contribuyen a que la información genética se transmita eficientemente de unos seres a otros, y se exprese en los nuevos individuos.

A través de estos conocimientos se ha permitido cruzar barreras naturales entre especies y colocar genes de cualquier organismo, en un organismo hospedador no relacionado mediante el empleo de técnicas de ingeniería genética.  La Biología Molecular ha sido tal que la ha conducido hacia una importante interdisciplinaridad a través de la interrelación con otras disciplinas. Con la ayuda de una avanzada tecnología y el dinamismo que le confiere su carácter interdisciplinario.
      
1.1.1._ El descubrimiento del principio transformante.

EXPERIMENTOS DE GRIFFITH (1928)

En 1928 en el transcurso de sus experimentos con la bacteria Streptococcus pneumoniae, Frederick Griffith había hecho una misteriosa observación. Esta bacteria humana causante de la neumonía humana, es normalmente letal para los ratones.


 Griffith utilizo en sus experimentos dos cepas que se distingan por la apariencia de las colonias crecidas en laboratorio. Las células de una de las cepas, de tipo virulento normal, están rodeadas por una cápsula de polisacáridos que le da a la colonia apariencia lisa (smooth); de ahí llamada estirpe S. Las células de la otra cepa  no virulenta que se reproduce en los ratones pero no es letal, carecen de esta cápsula de polisacáridos, lo cual hace que las colonias tengan apariencia rugosa; esta es la denominada estirpe R. Griffith mato algunas células bacterianas  virulentas, hirviéndolas e inyecto las células muertas en ratones. Los ratones sobrevivieron, demostrando así que las cápsulas de las células no provocan la muerte.  Sin embargo, ratones inyectados con una mezcla de células de la estirpe R y la estirpe S, murieron. Además podían recuperarse  bacterias vivas de los ratones muertos; esta producían colonias lisas y en subsiguientes inyecciones eran virulentas. De alguna manera, los restos celulares de la estirpe S hervidas habían convertido a la estirpe S vivas. Este proceso se denomina transformación.
      
EXPERIMENTOS DE McLeod y Mc McCarthy (1944)


En 1944, Oswald Avery, C. MacLeod y M. McCarty separaron los distintos tipos de moléculas que se encuentran en las células S   muertas y estudiaron su capacidad de transformación por separado.  Estas pruebas demostraron, en primer lugar, que la acción patogénica,  no es solo la expresión fenotípica de la virulencia. Tras el escrutinio de los diferentes compuestos (Polisacáridos, Lípidos, RNA, Proteínas y DNA). Descubrieron que solo DNA, inducía la transformación de las células del estirpe R, si no que el DNA es el agente que determina la aparición del polisacárido.

EXPERIMENTOS DE HERSEY Y CHASE (1952)

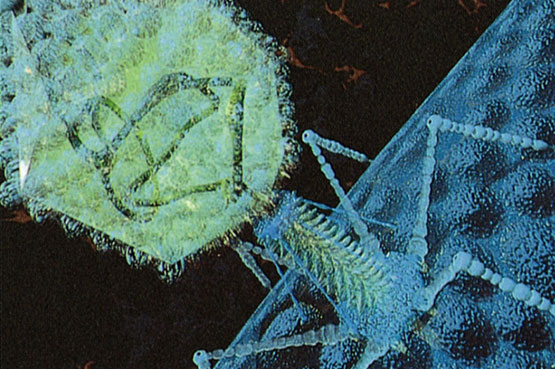
En 1952  Alfred Hersey y Martha Chase, usando el fago (virus T2). Su razonamiento fue que la infección del fago debe implicar la introducción dentro de la bacteria de la información que dicta la reproducción viral.

El fago es relativamente simple ya que la mayor parte de su estructura es proteina  en cuanto a la composición molecular. Alfred Hersey y Martha Chase descubrieron que las  proteínas no se encuentra fósforo, que si forma parte del DNA e inversamente, el azufre esta presente e las proteínas pero nunca en el DNA.
Para ello Hersey y Chase marcaron el DNA del fago con un radioisótopo del fósforo (P32)  y las proteínas con azufre (S35), en cultivos distintos de fagos. Usaron entonces cada cultivo por separado, para infectar E. coli con muchas partículas de virus por cada célula.  Tras dejar tiempo suficiente para que se produjera la infección, separaron de las células bacterianas las carcasas vacías de los fagos llamadas “fantasmas” mediante agitación con una batidora de cocina.  Posteriormente separaron las células bacterianas de los fantasmas de los fagos, mediante centrifugación, y midieron entonces la radioactividad en las dos fracciones. Cuando se usaron los fagos con P32, la mayor parte de la radioactividad terminaba en las células bacterianas, indicando que el DNA viral entraba en las células. Cuando se usaron fagos los fagos marcados con S35, la mayor parte de la radiactividad terminaba en los fantasmas virales, indicando que la proteína viral nunca entra en la célula bacteriana.